智能体长程记忆
上下文控制 · 可恢复外存 · 记忆生命周期
Agentic Long-Horizon Memory
Hello, I’m
博士研究生(硕博连读) · 中山大学
Ph.D. Student · Sun Yat-sen University
我的研究围绕智能体长程记忆、模型推理与计算系统展开,探索如何让大模型具备跨越长时程任务的记忆能力,并以可扩展的数据通路与计算架构,将算法层的认知能力落到真实世界的性能、容量与能效边界上。
My research sits at the intersection of agentic intelligence, model inference, and computing systems. I explore how to endow foundation models with long-horizon memory, and how to translate algorithmic capability into scalable data paths and computing architectures that push the practical limits of performance, capacity, and energy efficiency.
01 / Research Focus
面向具备持续任务能力的智能体,研究记忆如何在有限上下文、外部存储与专用硬件之间流动:算法决定何时保留、压缩与重访,系统组织活跃工作集,硬件扩展容量、带宽与能效。
上下文控制 · 可恢复外存 · 记忆生命周期
Agentic Long-Horizon MemoryKV Cache · 长上下文 · 异构协同调度
Memory-Aware Inference Systems存算协同 · FPGA · 容量、带宽与能效扩展
Memory-Centric Architectures02 / Selected Work
围绕长程记忆与高效推理的代表性研究工作,探索可扩展的数据流与存算架构、长上下文 Attention,以及端侧结构化稀疏执行。
PROJECT 01 · RHEOATTENTION
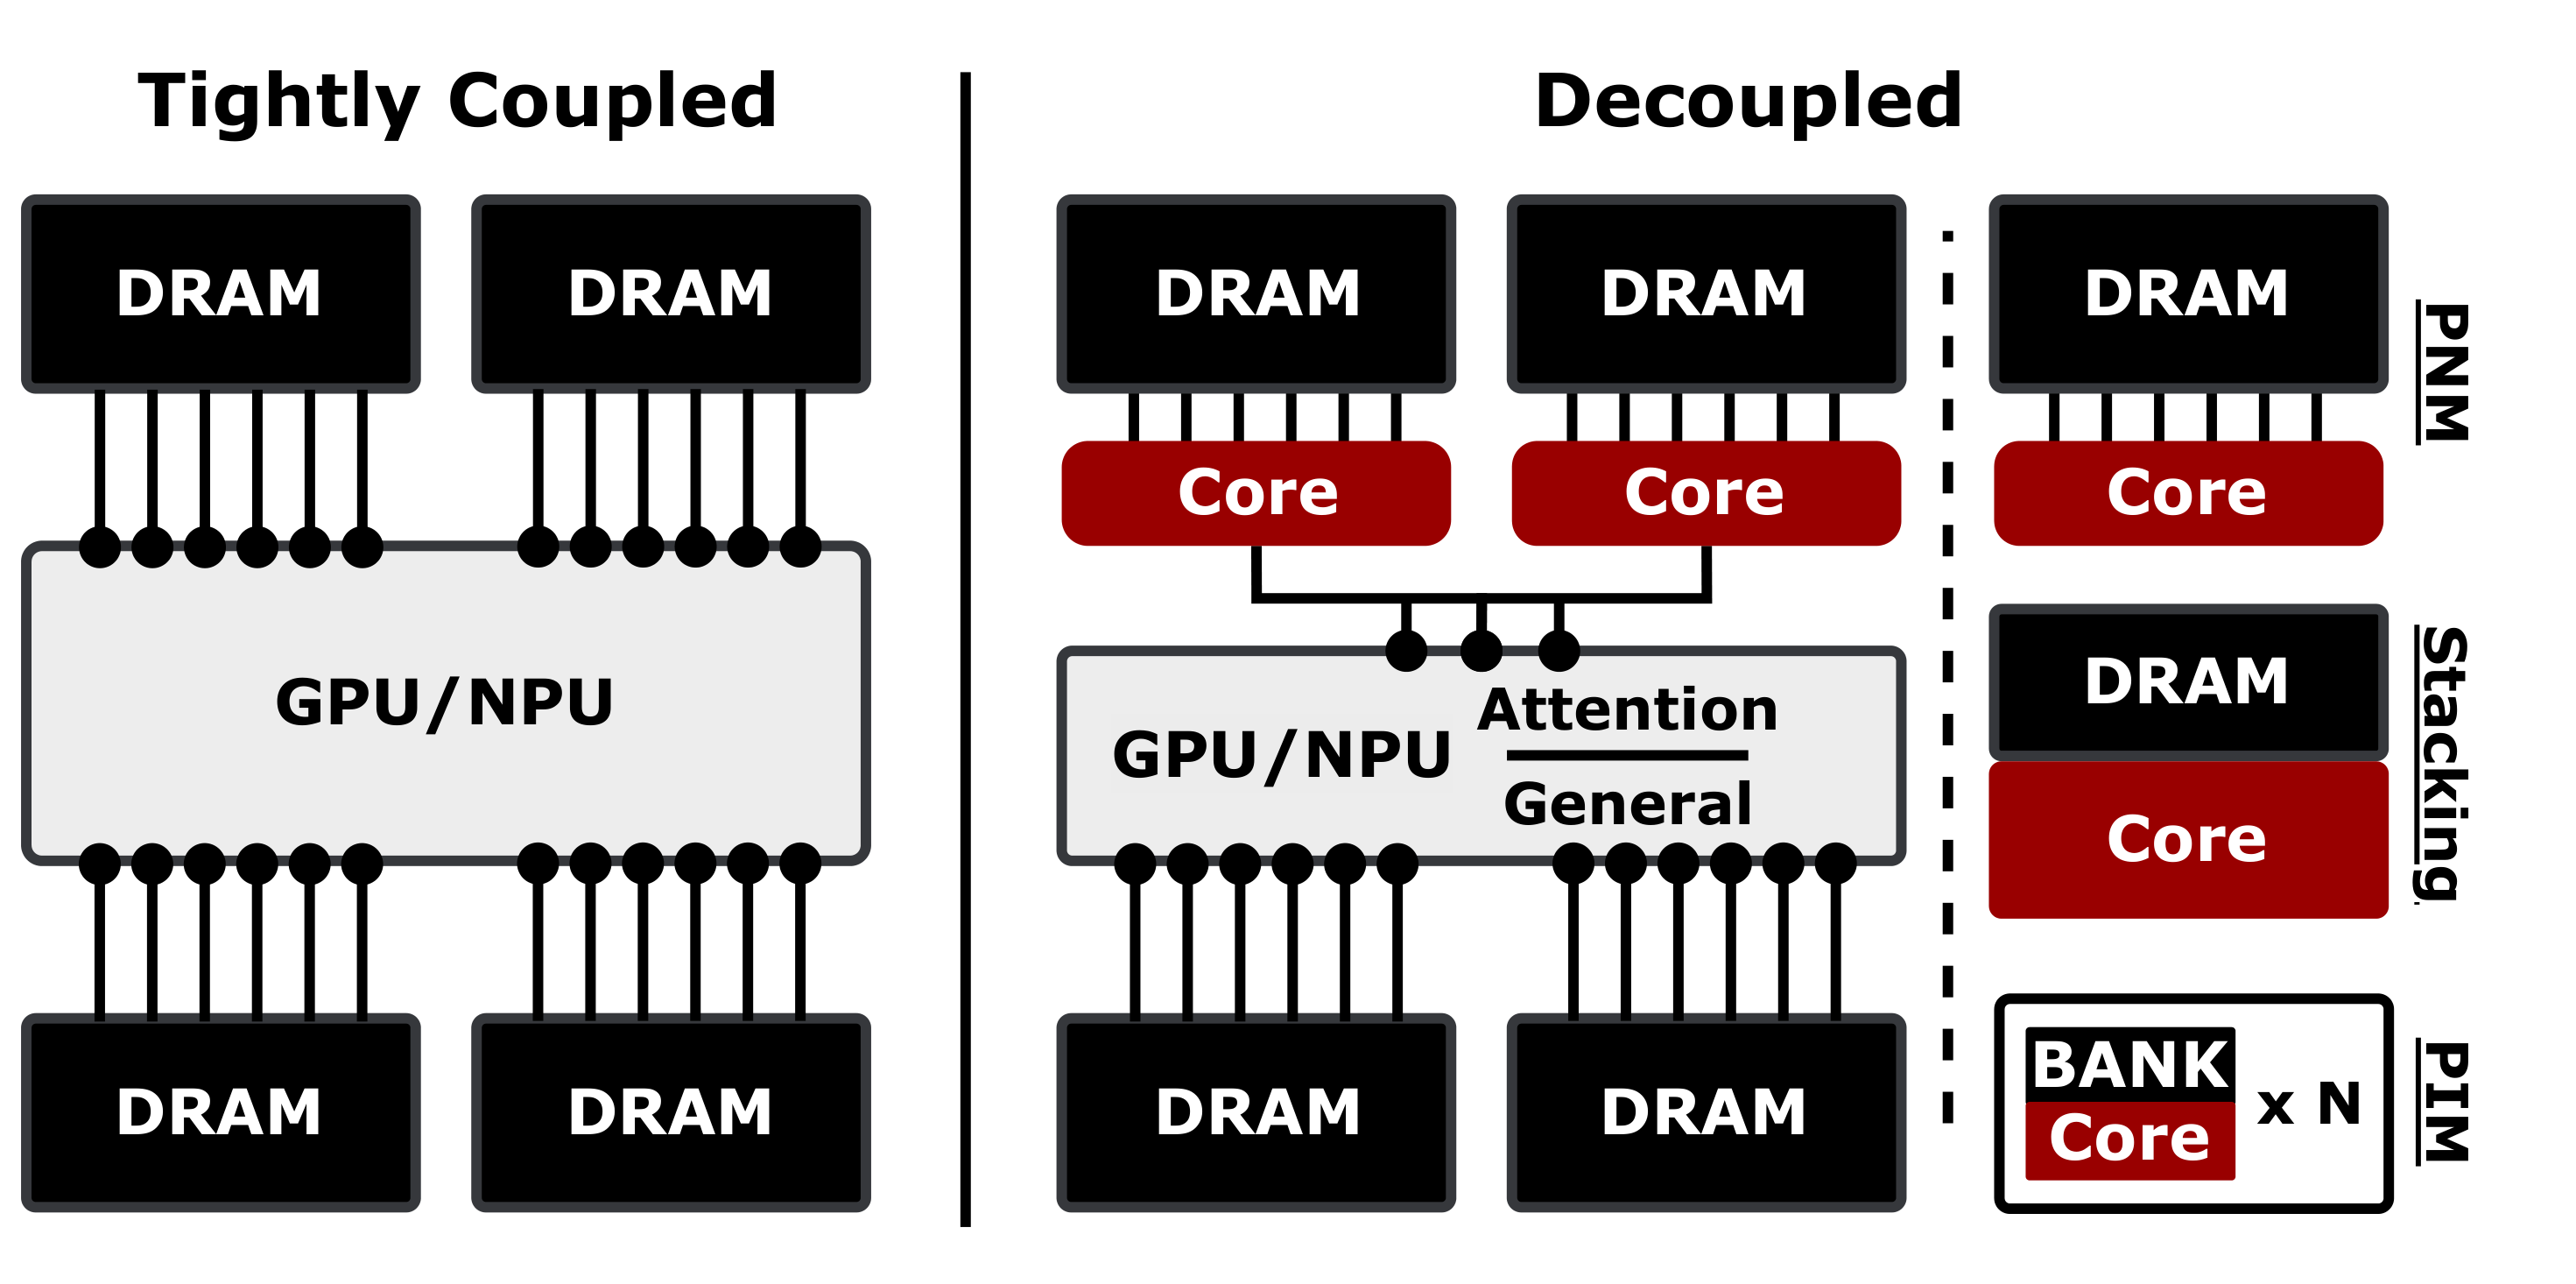
Memory-Side Attention Acceleration for 1M-Token Contexts
设计解耦式 Memory-Side Attention 架构与 Cascaded Attention 三级空间流水,使片上 Attention 状态与上下文长度无关;FPGA 原型达到 99.42% INT2 输入带宽利用率和 99.94% DDR 带宽利用率。
PROJECT 02 · RHEOSERVE
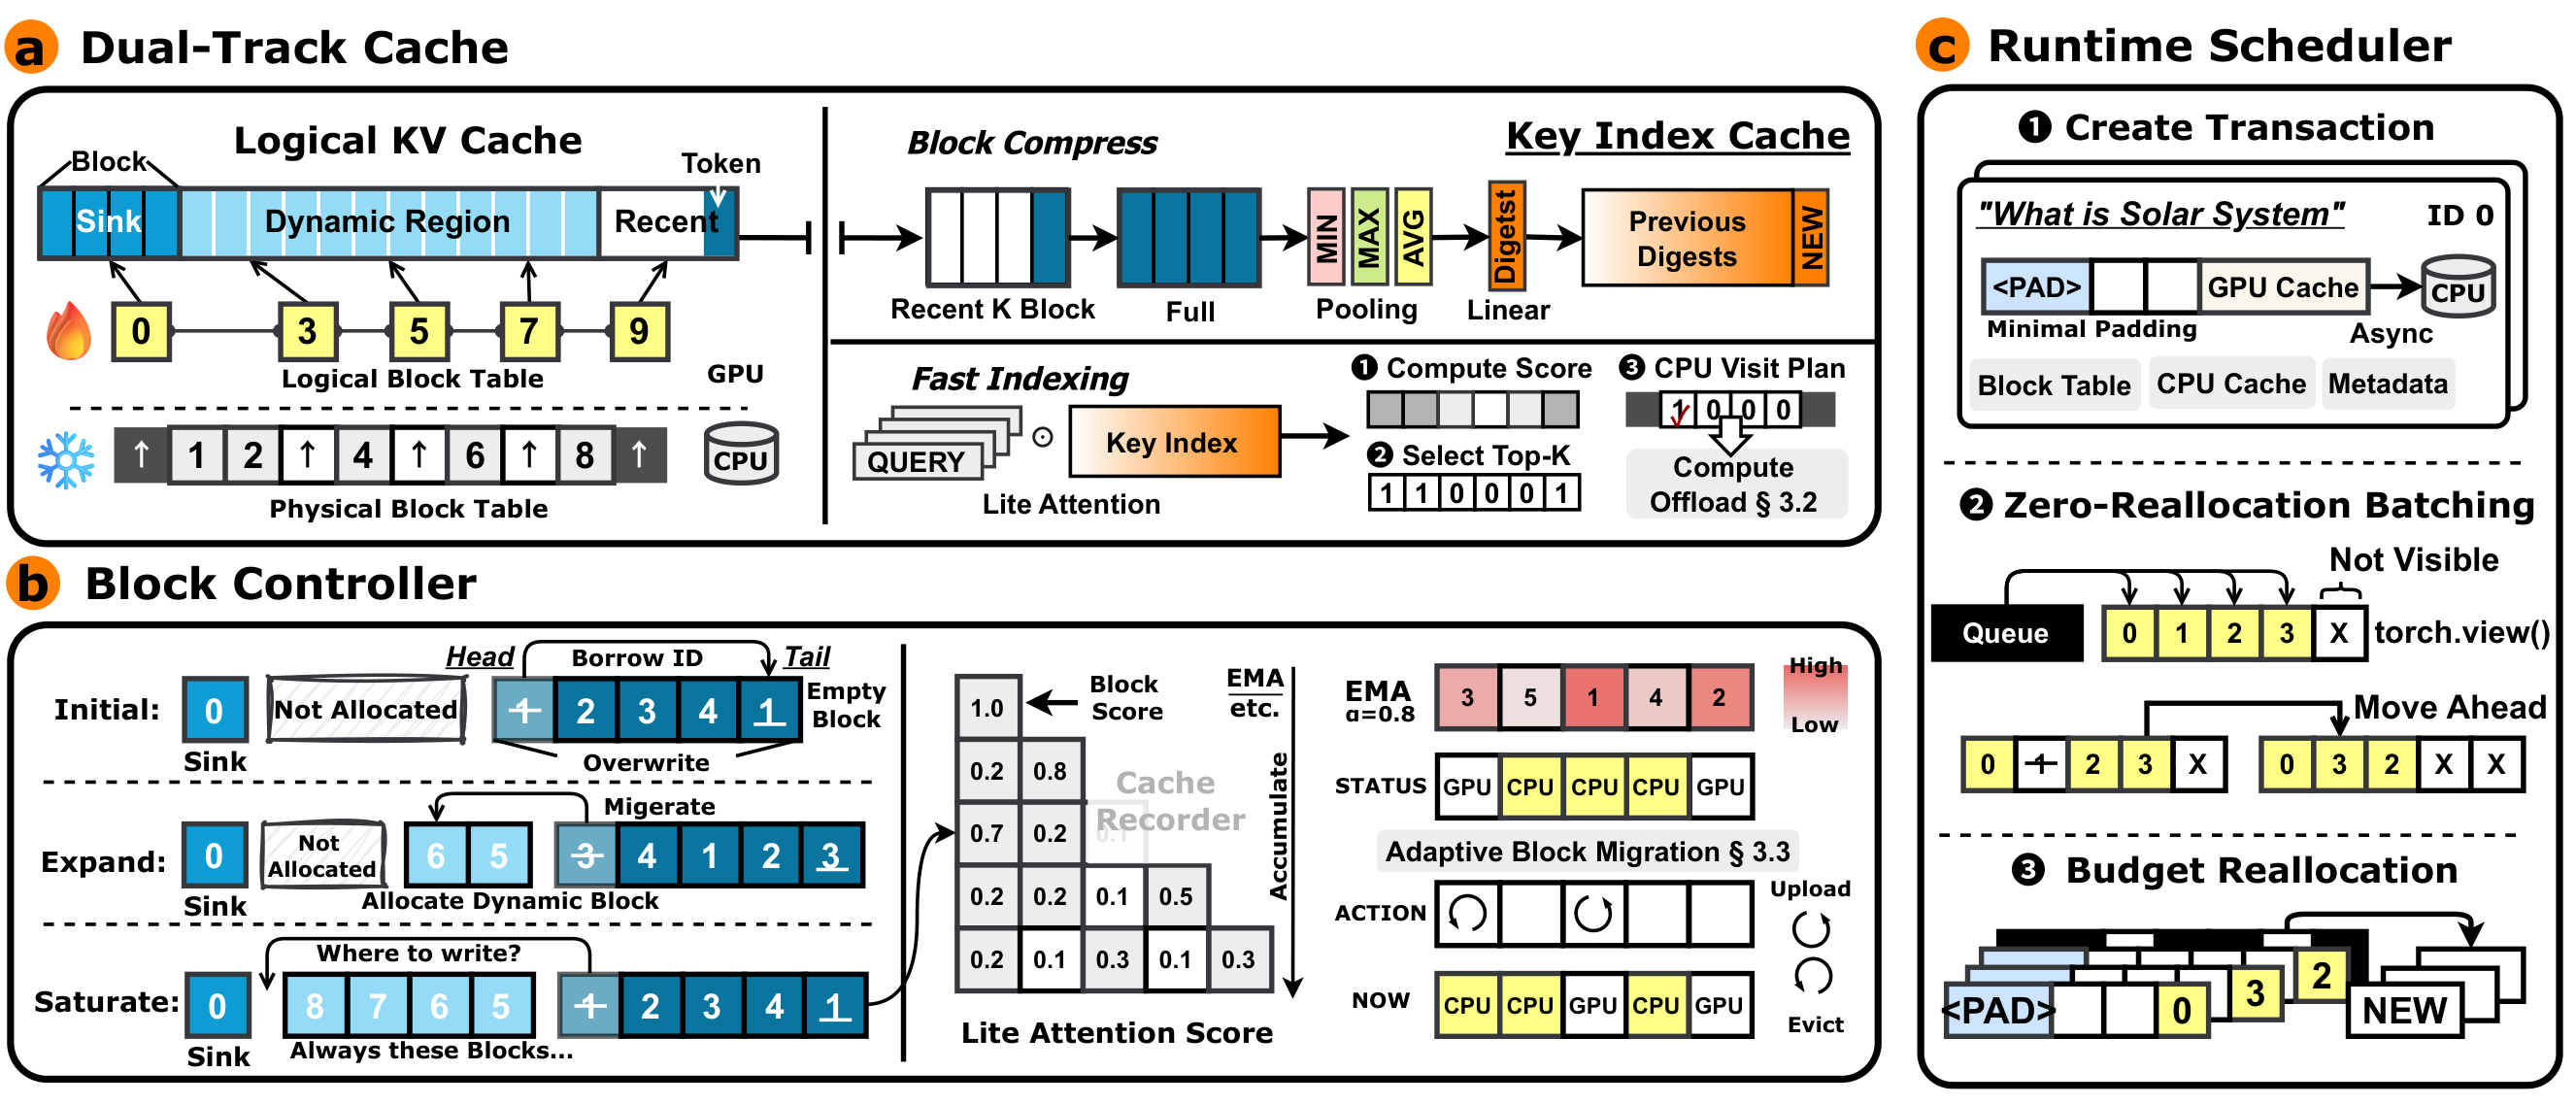
CPU–GPU Collaborative Sparse Attention for Long-Context Inference
提出 Logical KV Cache、Compute Offload 与 Adaptive Block Migration,将 Host Memory 扩展为 Attention 执行层;在 RTX 3090 上 Qwen3-4B / 8B 峰值吞吐达到 236.5 / 137.2 tok/s,最高达到 2.13× 加速。

PROJECT 03 · RHEOSPARSE
Fine-Grained Structured Sparsity for Small Language Models
提出支持任意 N:64 模式的结构化稀疏推理框架与 Bitmask SpMV Kernel;在 50% 稀疏率下平均准确率最高提升 4.80 个百分点,Decode 延迟最高降低 61.3% / 49.6%。
PROJECT 04 · TERAFLY
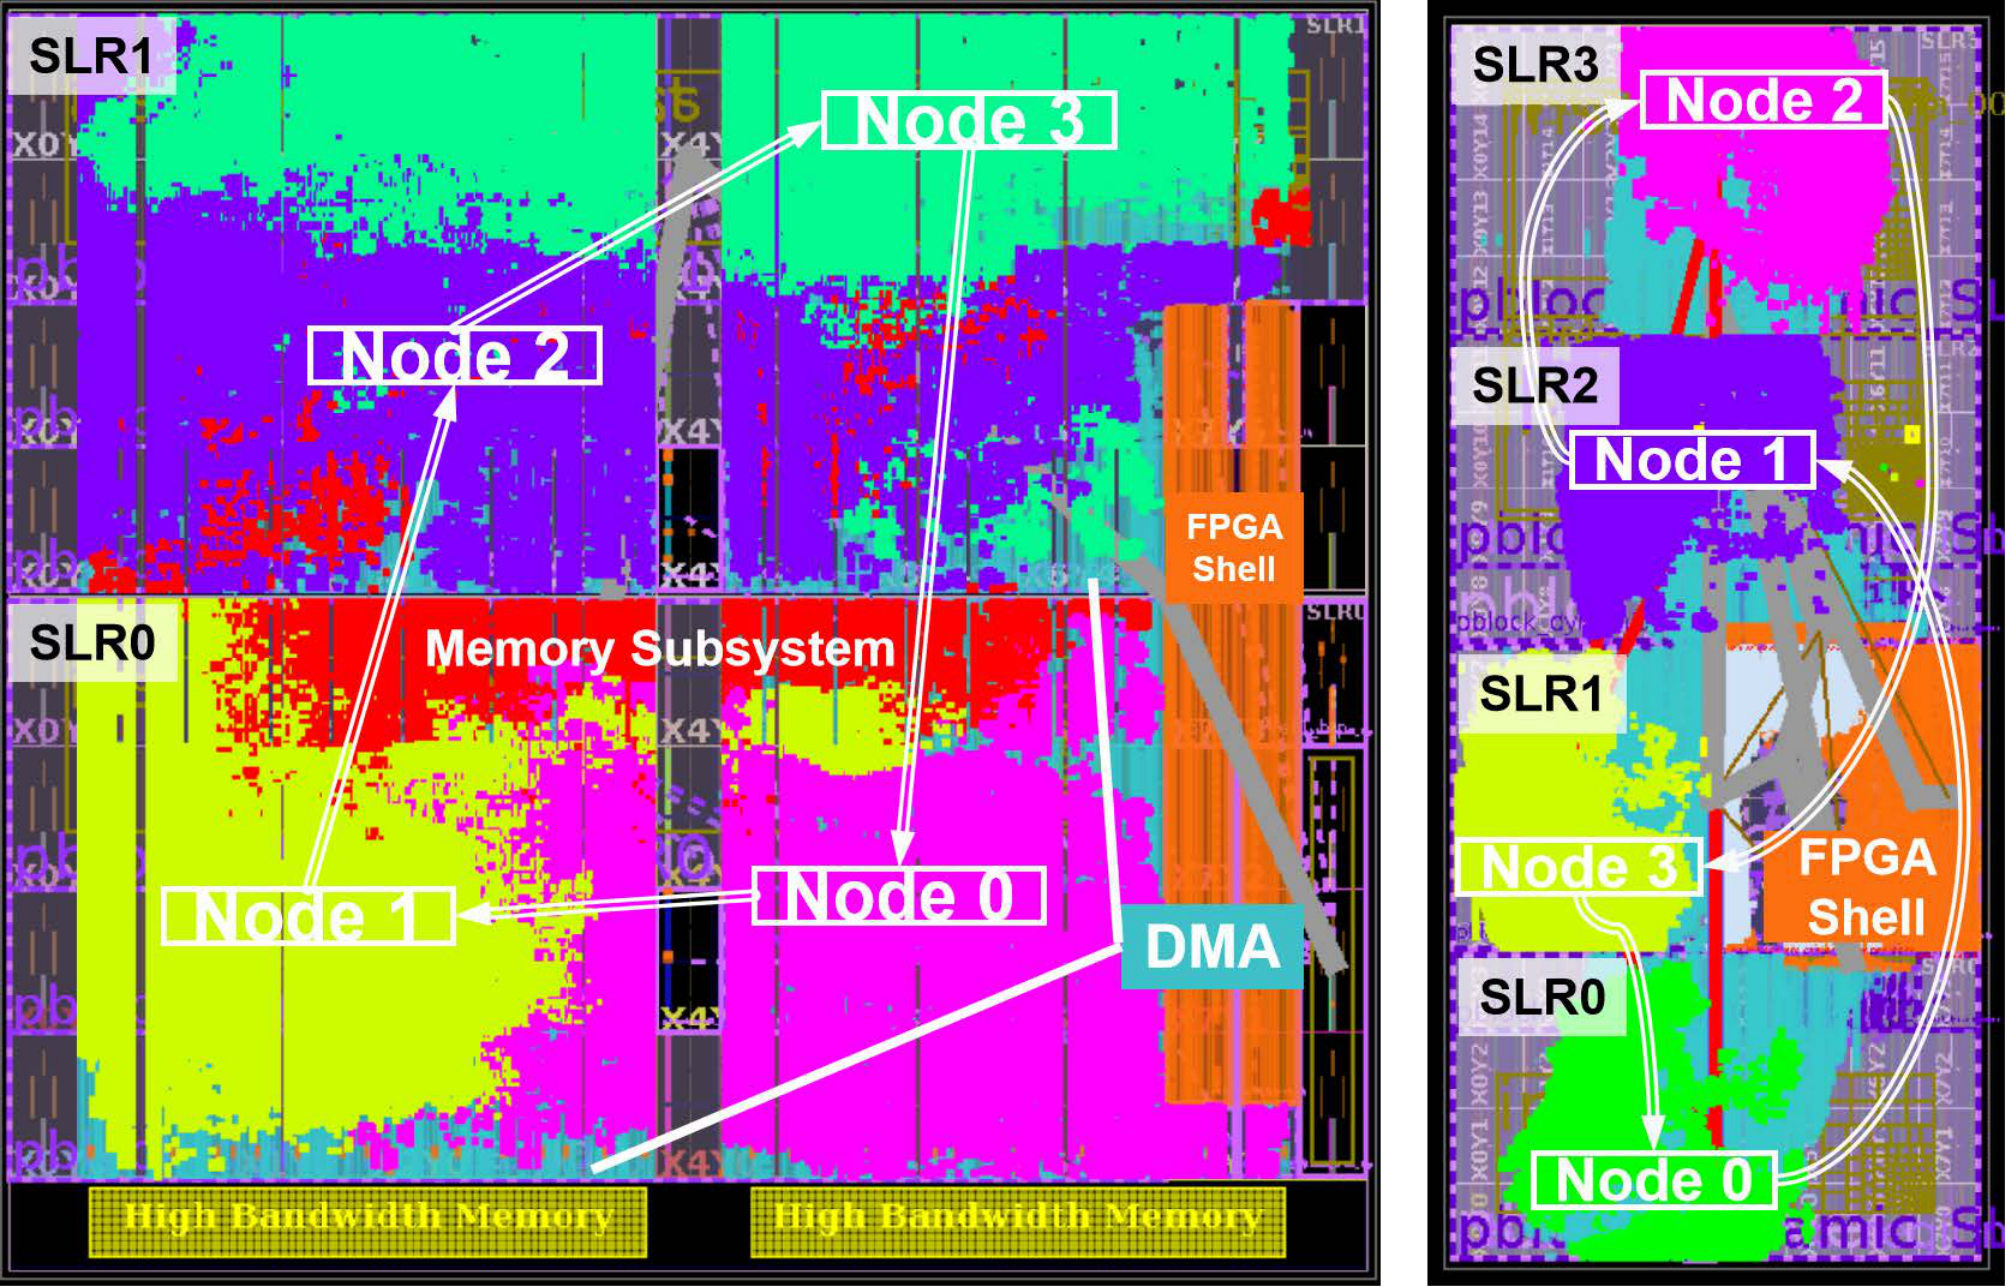
Efficient Accelerator Design for LLM Inference
针对自回归解码导致加速器峰值算力欠饱和及单节点缺乏可扩展性的问题,提出混合时空架构,以空间架构提升细粒度吞吐,以时间架构实现计算资源复用。
设计基于 HLS 的模板化代码生成框架,支持一键生成、并行扩展、环形组网与模块自动布局布线。端侧小模型 TPS 达到 GPU 的 1.1×,能耗优势达到 3.4×;相同资源下吞吐提升 50%。
03 / Publications
以第一作者身份开展的大语言模型系统与硬件加速研究。
Jianing Zheng, Gang Chen
DATE 2026 · CCF-B · EDA 领域四大顶级会议之一Jianing Zheng, Gang Chen, Libo Huang, Xin Lou, Wei-Shi Zheng
IEEE TCAD 2026 · CCF-A04 / Education
 Sun Yat-sen University
计算机技术 · 博士阶段
计算机科学与技术 · 硕士阶段
计算机科学与技术 · 本科 · 保送